Свой OpenAI-совместимый сервис
Вариант «OpenAI-совместимый» подключает любой сервис, который принимает запросы в формате OpenAI API: модель, развёрнутую на вашем сервере (Ollama, LM Studio, vLLM), корпоративный шлюз к нейросетям или другого провайдера, которого нет в списке.
Кому подходит:
- у компании уже есть свой шлюз к нейросетям;
- данные нельзя выпускать за периметр — запросы уходят на ваш сервер, а не во внешний сервис;
- нужен провайдер, которого модуль не поддерживает отдельно, но у которого есть OpenAI-совместимый API.
Что умеет в модуле
| Возможность | Поддержка |
|---|---|
| Каталог моделей | Список загружается с вашего сервера; если сервер его не отдаёт — код модели вводится вручную |
| Рассуждения | Да, если сервис их понимает: формат задаётся настройкой «Формат параметров рассуждения» |
| Веб-поиск | Нет |
| Проверка баланса | Нет — следите за расходом на стороне своего сервиса |
| Оплата | Зависит от вашего сервиса |
Что понадобится
Попросите у администратора вашего сервиса:
- URL эндпоинта — базовый адрес API, обычно заканчивается на
/v1. - API-ключ и способ его передачи — если сервис требует авторизацию.
- Дополнительные заголовки — если шлюз ждёт, например, идентификатор организации или проекта.
- Код модели — если сервер не отдаёт список моделей.
Подключение в модуле
- Откройте «Настройки → Основное», блок «LLM Провайдер».
- В поле «LLM-провайдер» выберите карточку OpenAI-совместимый.
- Заполните «API-ключ» (для локальных серверов без авторизации его можно оставить пустым) и появившиеся ниже настройки подключения — их описание в таблице ниже.
- Нажмите «Сохранить»: список моделей модуль загружает с сохранённого адреса.
- В блоке «Параметры модели» выберите «Модель по умолчанию» из списка сервера или нажмите «Ввести вручную…» и впишите код модели. Снова нажмите «Сохранить».
- Нажмите «Протестировать подключение» и отправьте тестовое сообщение.
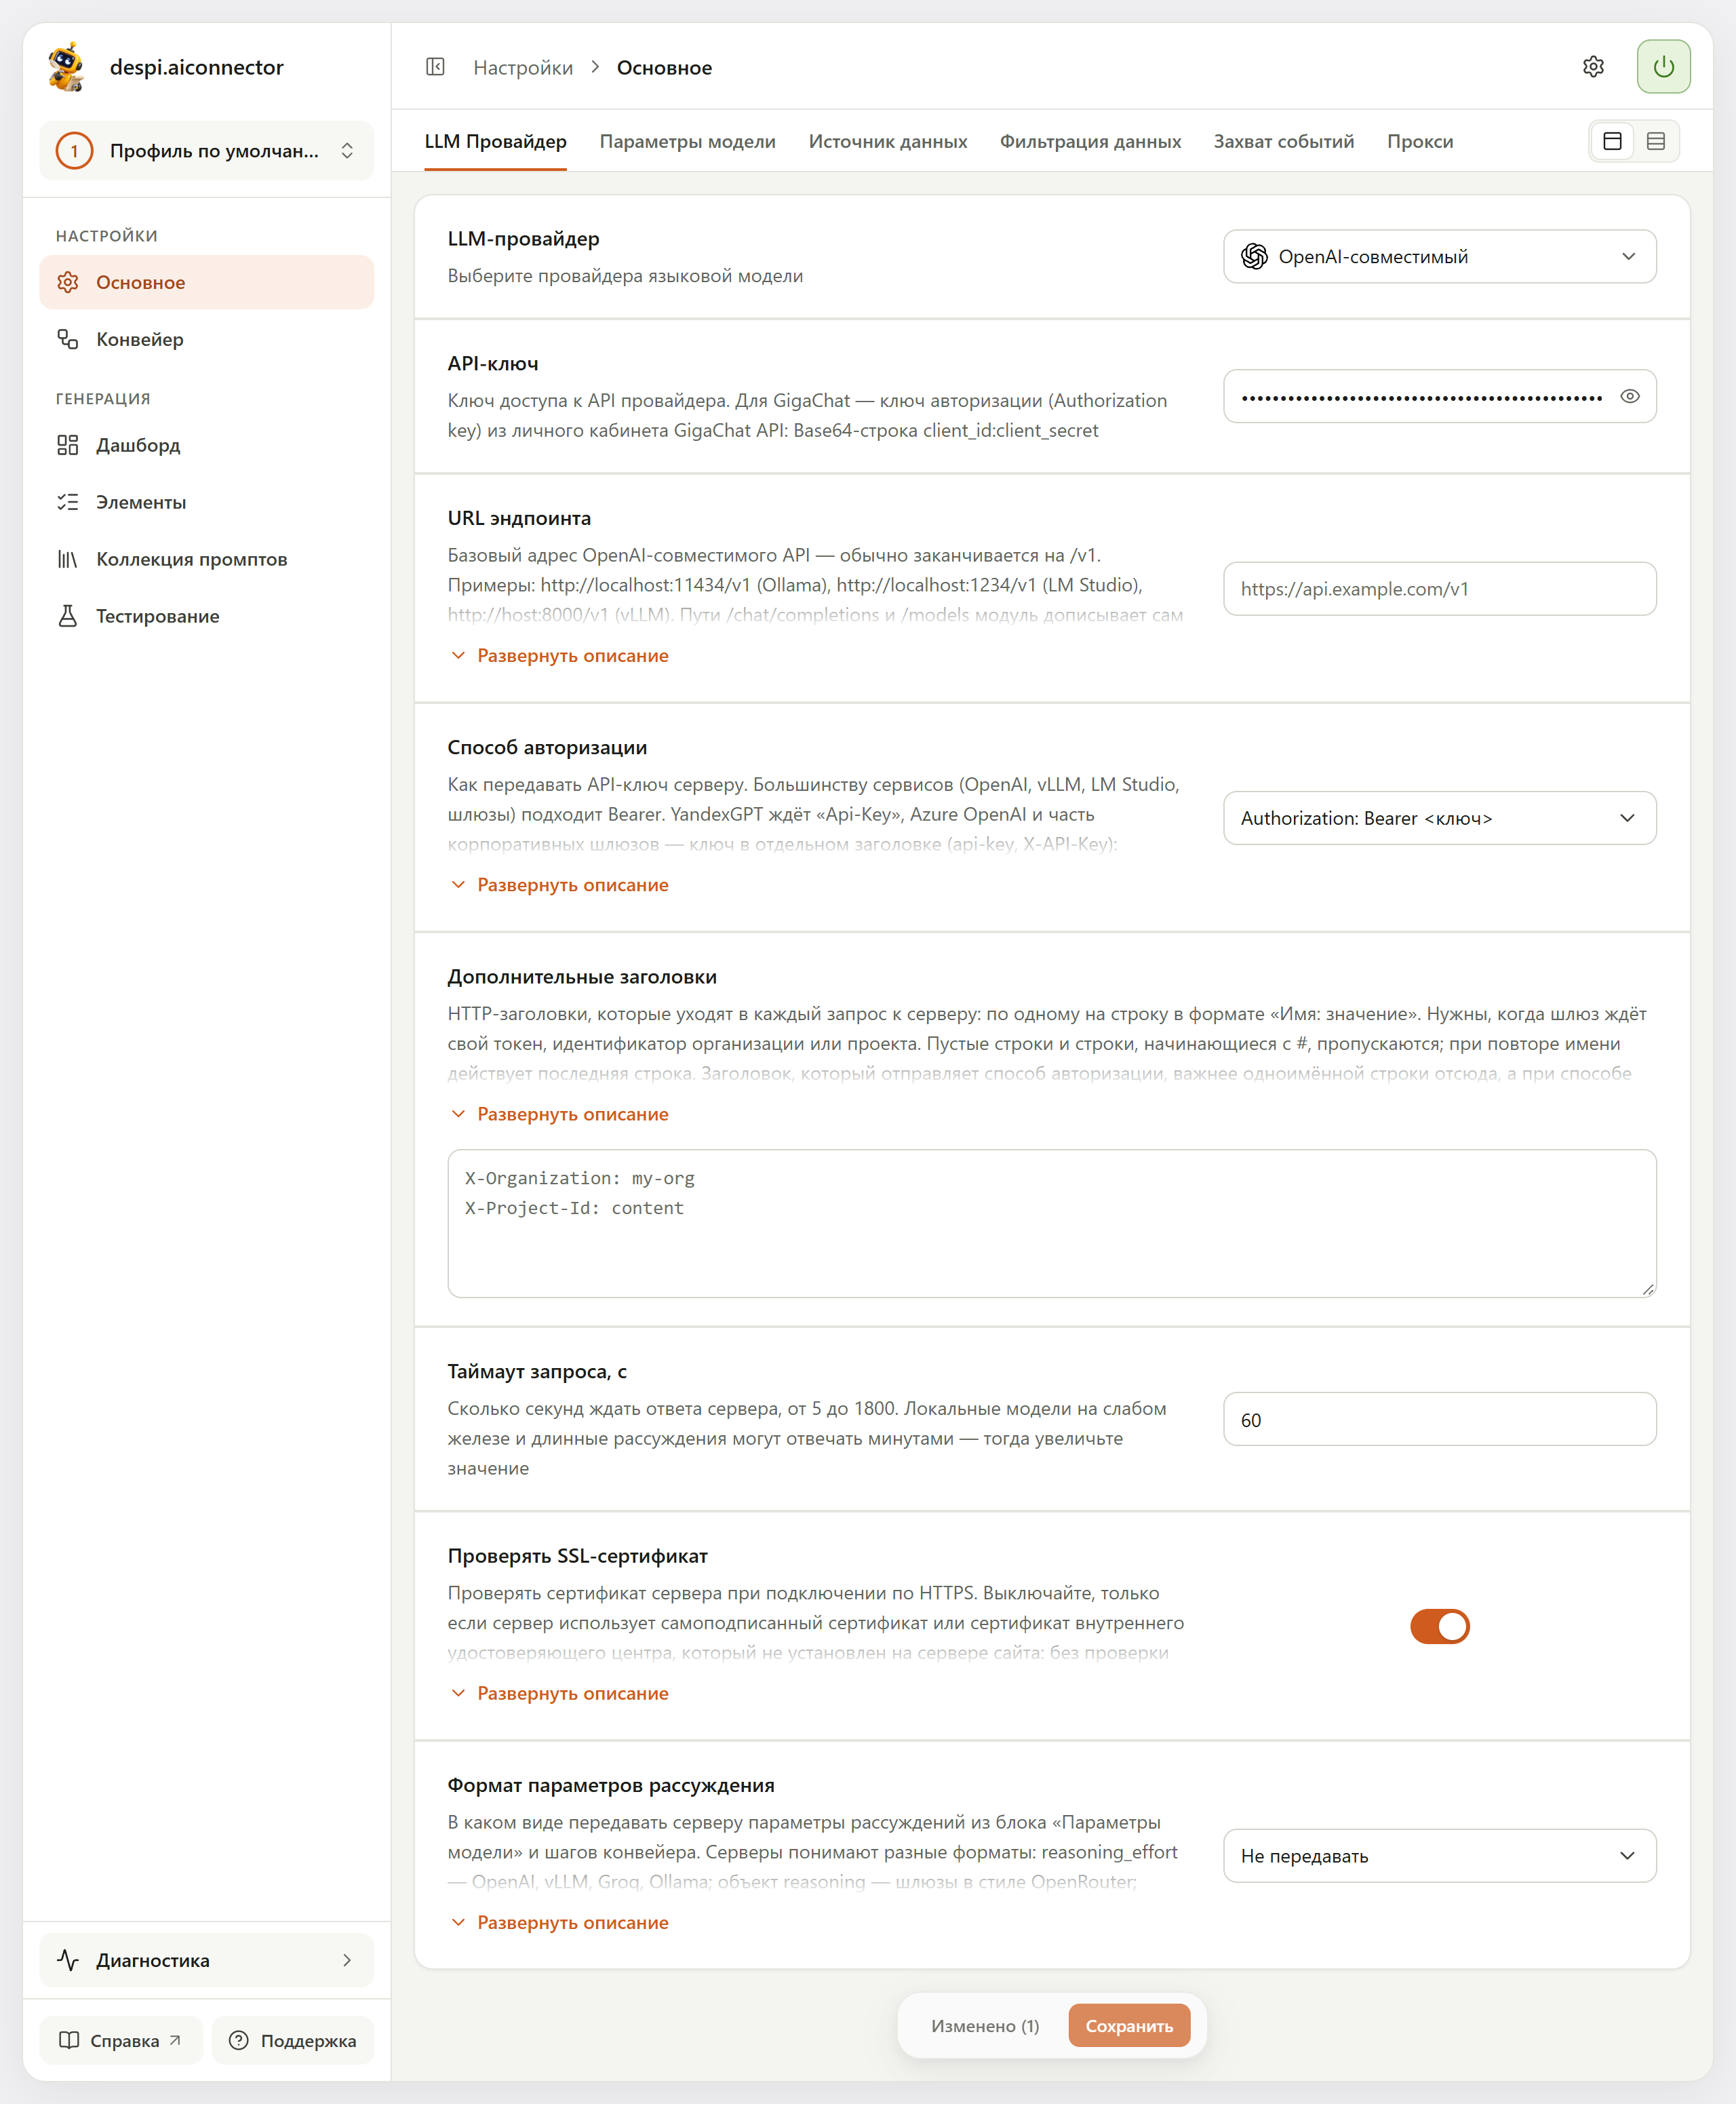
Настройки подключения
| Настройка | Что указать | По умолчанию |
|---|---|---|
| URL эндпоинта | Базовый адрес API: http://localhost:11434/v1 (Ollama), http://localhost:1234/v1 (LM Studio), http://host:8000/v1 (vLLM). Пути /chat/completions и /models модуль дописывает сам — указывать их не нужно. Параметры после «?» (например, ?api-version= у Azure) сохраняются и уходят в каждый запрос | Пусто |
| Способ авторизации | «Authorization: Bearer <ключ>» — подходит большинству сервисов (OpenAI, vLLM, LM Studio, шлюзы); «Authorization: Api-Key <ключ> (YandexGPT)»; «Свой заголовок» — ключ уходит в отдельном заголовке (Azure OpenAI, часть корпоративных шлюзов); «Без авторизации» — для локальных серверов вроде Ollama | Bearer |
| Имя заголовка с ключом | Появляется при способе «Свой заголовок»: например, api-key (Azure OpenAI) или X-API-Key. Латинские буквы, цифры и дефис, без пробелов и двоеточия | Пусто |
| Дополнительные заголовки | Заголовки для каждого запроса, по одному на строку: Имя: значение. Пустые строки и строки с # в начале пропускаются. Заголовки Host, Content-Length, Content-Type, Transfer-Encoding и Connection модуль задаёт сам. Значения не попадают в журнал и тексты ошибок | Пусто |
| Таймаут запроса, с | Сколько ждать ответа сервера, от 5 до 1800 секунд. Локальные модели на слабом железе и длинные рассуждения могут отвечать минутами — тогда увеличьте | 60 |
| Проверять SSL-сертификат | Выключайте, только если сервер использует самоподписанный сертификат или сертификат внутреннего удостоверяющего центра, который не установлен на сервере сайта. Для адресов http:// настройка не действует | Включено |
| Формат параметров рассуждения | Как передавать настройки рассуждений: «Не передавать»; reasoning_effort — OpenAI, vLLM, Groq, Ollama; объект reasoning — шлюзы в стиле OpenRouter; enable_thinking — модели Qwen3 на vLLM и SGLang (только включить или выключить) | Не передавать |
Если выключить «Проверять SSL-сертификат», соединение можно перехватить, подменить ответы и узнать API-ключ. Делайте это только для своего сервера во внутренней сети.
Модель
Модуль запрашивает у сервера список моделей (/models) с сохранёнными адресом, авторизацией и заголовками. Если что-то из этого поменяли, сначала сохраните настройки — подсказка под полем модели напомнит, что новый адрес ещё не используется.
Если сервер список не отдаёт, под полем появится «Список моделей недоступен» с причиной — введите код модели вручную так, как он указан в документации сервера (например, llama3.1:8b у Ollama). Модель, которой нет в списке сервера, помечается «нет в списке сервера».
Рассуждения
Каталог сервера ничего не сообщает о рассуждениях, поэтому их поддержку определяет «Формат параметров рассуждения»:
| Формат | Что можно настроить |
|---|---|
| Не передавать | Ничего — блок рассуждений в «Параметрах модели» не показывается |
| reasoning_effort | Включение и уровень рассуждения |
| Объект reasoning | Включение, уровень, лимит токенов и скрытие текста рассуждения |
| enable_thinking | Только включить или выключить рассуждение |
Если модель не рассуждает или формат неизвестен, оставьте «Не передавать». Если модель вставляет ход рассуждения в начало ответа, модуль сам вырезает его из текста.
Особенности
- Сервер сайта должен «видеть» ваш сервис. Запросы отправляет сервер, на котором работает сайт, а не ваш браузер. Если сервис во внутренней сети, убедитесь, что сервер сайта имеет к нему доступ; адрес
localhostозначает сервер сайта. Если внешние запросы идут через прокси — заполните блок «Прокси». - Ошибка 404 — обычно неверный адрес. Проверьте, что URL эндпоинта заканчивается на
/v1(или как требует документация сервиса) и не содержит/chat/completions. - Своя модель на шаге выбирается так же — из списка сервера или вводом кода.
- Веб-поиск на шаге для этого варианта недоступен. Если он нужен, используйте Polza.ai, OpenRouter или DeepSeek.